Tech News /
Il Giappone vuole costruire il supercomputer più potente sul pianeta: cos'è Fugaku Next.
Fugaku Next: il supercomputer zettascale del Giappone da $750M. Dalle performance per l'AI al nodo energia, la nuova sfida tra USA e Asia per il calcolo avanzato.

Smart Shaped
Ultimo aggiornamento: settembre 2026
Fugaku Next (o FugakuNEXT) è il progetto del Giappone per realizzare un supercomputer di nuova generazione con ambizioni “zettascale”, cioè orientato a prestazioni nell’ordine degli zettaFLOPS per carichi di Intelligenza Artificiale. Coordinato da MEXT, RIKEN e Fujitsu, il sistema punta a entrare in funzione intorno al 2030 e a superare i leader exascale attuali.
La corsa al supercomputer più potente del mondo non è solo una gara di numeri: è un indicatore di capacità nazionale su AI, simulazioni e ricerca avanzata. In questa guida troverete: definizioni (FLOPS, exascale, zettascale), confronto con Frontier e Fugaku, costi e tappe fino al 2030, e soprattutto il tema spesso ignorato di energia, raffreddamento e sostenibilità.
Che cos’è Fugaku Next e perché il Giappone vuole il supercomputer più potente del mondo
Fugaku Next (FugakuNEXT) è il progetto giapponese per un supercomputer “flagship” zettascale, pensato per diventare un riferimento mondiale entro circa il 2030 e sostenere la crescita di AI e calcolo scientifico. Il programma è guidato da MEXT (Ministero dell’Istruzione, Cultura, Sport, Scienza e Tecnologia) con RIKEN (National Research and Development Institute) e Fujitsu come partner chiave.
RIKEN descrive l’obiettivo come la realizzazione della “world’s first zetta-scale performance in AI (FP8)” e la costruzione di un ecosistema globale di utilizzo e distribuzione del sistema (RIKEN Center for Computational Science: FugakuNEXT). In altre parole, la spinta non riguarda solo il primato, ma la capacità di addestrare e usare modelli AI e di eseguire simulazioni che oggi risultano troppo lente o troppo costose.
These combined efforts aim to deliver a competitive system achieving the world's first zetta-scale performance in AI (FP8) and to build a global ecosystem through worldwide deployment.
— RIKEN Center for Computational Science, National Research and Development Institute
In prospettiva geopolitica, un’infrastruttura HPC (High-Performance Computing) di fascia zettascale diventa un tassello di sovranità tecnologica nella competizione globale sull’AI. Per una lettura più ampia del contesto, vedi anche la corsa globale all'intelligenza artificiale tra USA, Cina ed Europa.
Che cosa significa zettaFLOPS e come si misura la potenza di un supercomputer
Un supercomputer è un sistema di calcolo progettato per eseguire enormi quantità di operazioni in parallelo, così da risolvere problemi complessi (AI, fisica, clima, genomica) in tempi ridotti. La potenza viene spesso descritta in FLOPS (Floating Point Operations Per Second, cioè operazioni in virgola mobile al secondo), una metrica standard nel supercalcolo e nelle classifiche come TOP500 (la lista dei supercomputer più potenti).
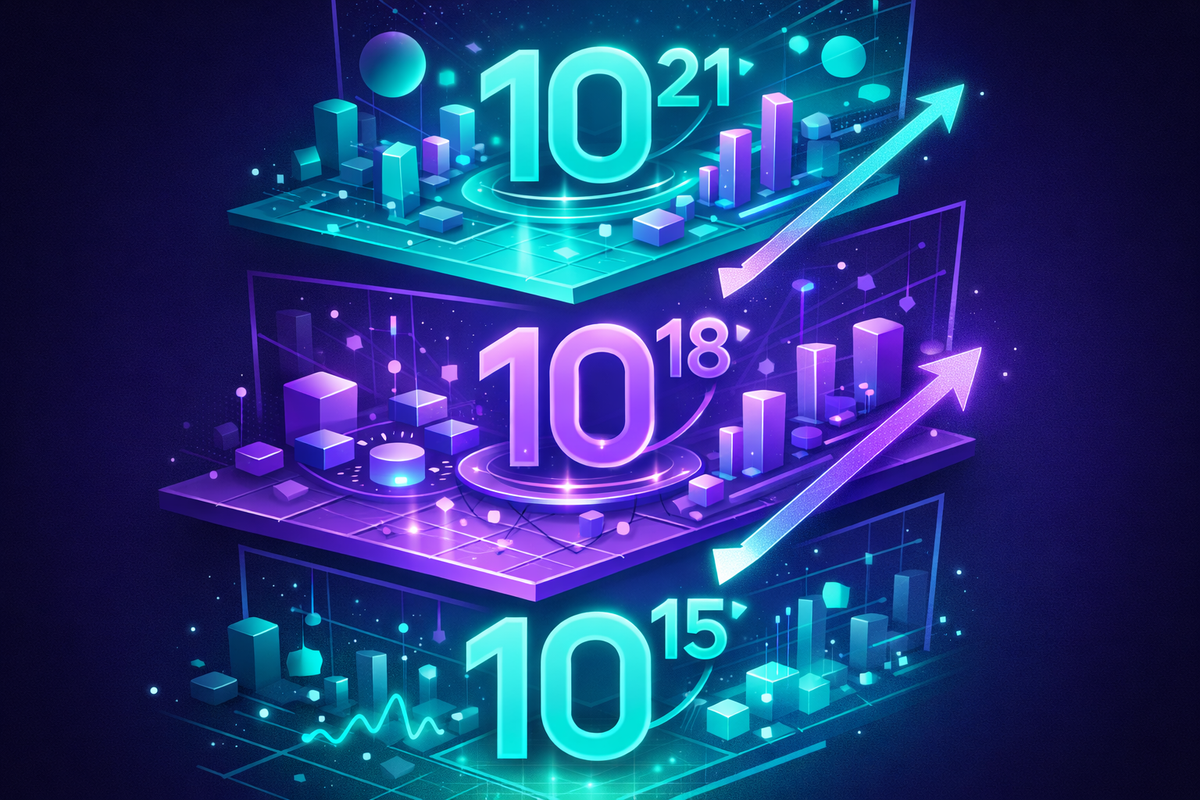
ExaFLOPS indica l’ordine di grandezza 10^18, mentre zettaFLOPS indica 10^21: tre ordini di grandezza in più. Questo salto non significa automaticamente “1000 volte più veloce” in ogni scenario, perché contano anche memoria, rete e software, ma rende possibile affrontare modelli e simulazioni con dimensioni oggi impraticabili.
| Scala | Notazione | Ordine di grandezza | Esempio d’uso tipico |
|---|---|---|---|
| PetaFLOPS | PFLOPS | 10^15 | Simulazioni ingegneristiche avanzate |
| ExaFLOPS | EFLOPS | 10^18 | AI su larga scala, clima, fisica |
| ZettaFLOPS | ZFLOPS | 10^21 | AI-for-science “massiva”, digital twin |
Per capire “quanto è grande” zetta, basta ricordare che passare da 10^18 a 10^21 vuol dire moltiplicare per 1000 la capacità teorica. Nella pratica, l’obiettivo è portare quel salto anche nelle prestazioni sostenute dalle applicazioni.
Fugaku Next vs Frontier vs Fugaku: confronto tra i supercomputer che definiscono la corsa globale
Frontier è il riferimento exascale negli Stati Uniti, Fugaku è stato il simbolo della leadership giapponese fino al 2022, e Fugaku Next punta a un salto di scala con un’impostazione più orientata anche ai workload AI. Il confronto è utile solo se si distingue tra prestazioni misurate e target di progetto: per Fugaku Next molti numeri sono ancora obiettivi dichiarati, non benchmark finali.
| Sistema | Paese | Istituzione / sito | Classe prestazioni | Anno | Uso principale | Stato |
|---|---|---|---|---|---|---|
| Frontier | USA | Oak Ridge National Laboratory (ORNL) | Exascale (misurato) | 2022+ | HPC scientifico + AI | Operativo |
| Fugaku | Giappone | RIKEN Center for Computational Science (Kobe) | Exascale (picco ~0,44 EFLOPS) | 2020+ | HPC scientifico | Operativo |
| Fugaku Next | Giappone | RIKEN + Fujitsu + MEXT | “Zettascale” per AI (target FP8) | ~2030 | AI-for-science + simulazioni | In sviluppo |
Secondo un’analisi di settore, FugakuNEXT mira a oltre 2,6 exaFLOPS FP64 (prestazioni di picco aggregate) e a circa 600 exaFLOPS FP8 sparse per AI, cifra presentata come “zettascale” per carichi AI (Supercomputing.news, 2026: analysis). Il punto chiave è che zettascale, qui, è legato soprattutto a precisioni AI (FP8) più che al classico FP64 del supercalcolo tradizionale.
Il confronto, quindi, non è marketing se viene letto correttamente: misura la capacità di un Paese di spingere insieme HPC e AI, e di farlo con architetture e software che scalano davvero.
Chi finanzia il progetto e quali sono le tappe previste fino al 2030
Il progetto Fugaku Next è sostenuto principalmente dallo Stato giapponese attraverso MEXT, con RIKEN come organismo di ricerca e Fujitsu come partner industriale. Le cifre circolate finora vanno interpretate come budget approvati per fasi iniziali e stime complessive che possono cambiare durante progettazione e procurement.
Secondo Supercomputing.news, MEXT avrebbe approvato circa 4,2 miliardi di yen per il primo anno di sviluppo e un budget indicativo complessivo intorno a 110 miliardi di yen (circa 740–761 milioni USD, conversione indicativa riportata dalla stampa di settore) (Supercomputing.news, 2026: fonte). Per inquadrare investimenti comparabili, puoi leggere anche investimenti italiani in nuovi supercomputer e AI Factory.
| Fase | Obiettivo | Finestra temporale (indicativa) | Nota |
|---|---|---|---|
| Avvio & funding iniziale | Definizione requisiti e governance | 2025–2026 | Budget e specifiche possono evolvere |
| Co-design architettura | CPU/GPU, memoria, rete, software | 2026–2028 | Focus su AI + HPC |
| Costruzione & integrazione | Installazione nel sito RIKEN (Kobe) | 2028–2029 | Fase logistica critica |
| Commissioning | Test, tuning applicazioni, affidabilità | 2029–2030 | Possibile overlap con Fugaku |
| Entrata in esercizio | Avvio operativo | ~2030 | Obiettivo dichiarato da RIKEN |
La stessa fonte indica una sovrapposizione di 2–3 anni tra Fugaku e FugakuNEXT durante la messa in servizio, per garantire continuità ai programmi scientifici (Supercomputing.news, 2026).
Quali sfide tecniche deve superare un supercomputer zettascale
Un supercomputer zettascale non nasce semplicemente “aggiungendo chip”: la scalabilità richiede risolvere colli di bottiglia di architettura, memoria, interconnessione, affidabilità e software. Fugaku Next si colloca proprio su questo crinale, dove HPC tradizionale e AI moderna impongono requisiti diversi (precisioni FP64 vs FP16/FP8, throughput vs latenza).
- Processori e acceleratori: architetture eterogenee (CPU + GPU/NPU) aumentano efficienza e prestazioni AI. Un comunicato ufficiale descrive la collaborazione RIKEN–Fujitsu–NVIDIA per il successore di Fugaku (NVIDIA News, 17 nov 2025: fonte).
- Memoria e bandwidth: senza sufficiente banda, la potenza di calcolo resta inutilizzata. Qui contano HBM (High-Bandwidth Memory) e coerenza CPU-GPU.
- Rete ad alte prestazioni: l’interconnessione è essenziale per distribuire training e simulazioni, riducendo la latenza tra nodi.
- Affidabilità (fault tolerance): a grande scala, guasti e bit flip diventano frequenti; servono checkpointing e resilienza software.
- Prestazioni reali vs teoriche: picchi in FLOPS contano meno della performance applicativa, spesso misurata su benchmark e workload concreti.
Per dettagli tecnici discussi in ambiente specialistico, esistono anche analisi di roadmap e scelte architetturali (es. ARM/NPU e coerenza memoria) come quelle raccolte da ArmDevices (2025: approfondimento), utili per capire i trade-off.
Energia, raffreddamento e sostenibilità: il vero costo nascosto della potenza zettascale
L’ostacolo più duro per un supercomputer zettascale è l’energia, non solo la velocità. Il vincolo reale è quanta potenza elettrica serve per sostenere il calcolo e, soprattutto, quanta energia è necessaria per rimuovere calore in modo stabile, sicuro e continuativo in un data center HPC.
Nel mondo HPC esistono metriche e classifiche come Green500 (efficienza energetica dei supercomputer) che spostano l’attenzione su prestazioni per watt, oltre ai FLOPS assoluti. In un contesto zettascale, l’efficienza per watt diventa la differenza tra un sistema usabile e un progetto economicamente insostenibile.
Le strategie più plausibili combinano: (1) raffreddamento avanzato (liquido, immersion), (2) acceleratori più efficienti per AI (riducendo sprechi su FP8/FP16), (3) ottimizzazione software per minimizzare comunicazioni e accessi a memoria, (4) pianificazione energetica del sito per resilienza e continuità operativa. Dal lato governance e reporting, molte aziende collegano già infrastrutture e sostenibilità a framework ESG; in ottica applicativa può essere utile anche strumenti per l'implementazione ESG nelle aziende e intelligenza artificiale al servizio della sostenibilità ESG.
A cosa servirà Fugaku Next: AI, clima, farmaci e simulazioni industriali
Fugaku Next non servirebbe solo a battere record: l’obiettivo è accelerare AI e simulazioni che oggi richiedono tempi o scale proibitive, soprattutto in ambito AI-for-science. RIKEN indica l’orientamento a prestazioni zettascale per AI (FP8) come parte del disegno complessivo del sistema (RIKEN: overview).
- Modelli AI e AI generativa: più compute permette training e inferenza su modelli più grandi e dataset più ricchi, con maggiore sperimentazione.
- Climate modeling: simulazioni climatiche ad alta risoluzione beneficiano di calcolo e parallelismo; un esempio di approccio ibrido AI+fisica è il modello NeuralGCM per previsioni climatiche integrate con AI.
- Drug discovery: docking, dinamica molecolare e screening virtuale aumentano di scala con più potenza di calcolo.
- Materiali avanzati: simulazioni quantistiche e multi-scala accelerano la progettazione di nuovi materiali.
- Digital twin industriali: modelli “gemelli digitali” di impianti e supply chain richiedono HPC e data engineering; un riferimento applicativo è progetto Farm Tech e sviluppo sperimentale per simulazioni industriali.
Nel linguaggio della trasformazione digitale, un’infrastruttura così abilita sperimentazione rapida, riduzione dei tempi di R&D e integrazione tra dati, modelli e simulazione. Per le organizzazioni, questo si collega anche a temi di governance dell’AI e gestione del rischio; in ambito europeo può essere rilevante la guida completa alla governance AI e conformità con EU AI Act.
FAQ su Fugaku Next, zettaFLOPS, costi e tempi
Quanto costerà Fugaku Next?
Le stime citate dalla stampa di settore parlano di un budget complessivo indicativo intorno a 110 miliardi di yen (circa 740–761 milioni USD), ma la cifra può cambiare con progettazione e approvvigionamenti. Il finanziamento iniziale riportato include anche fondi per il primo anno di sviluppo (2026).
ZettaFLOPS significa davvero 1000 volte più veloce di exaFLOPS?
ZettaFLOPS indica un ordine di grandezza tre zeri sopra exaFLOPS (10^21 vs 10^18), quindi 1000× in termini teorici di FLOPS. Nelle applicazioni reali, però, entrano in gioco memoria, rete e software: il guadagno può essere inferiore o diverso a seconda del workload.
Quando dovrebbe entrare in funzione Fugaku Next?
L’obiettivo dichiarato è l’avvio operativo intorno al 2030, vicino al sito RIKEN di Kobe. Alcune fonti di settore indicano anche una fase di commissioning con sovrapposizione di 2–3 anni con l’attuale Fugaku, per garantire continuità alle attività scientifiche durante la transizione.
Fugaku Next punta alla classifica TOP500 come Frontier?
Non è detto che l’obiettivo primario sia “vincere” TOP500 con un singolo numero, perché la progettazione sembra enfatizzare performance applicativa e carichi AI (come FP8) oltre al classico FP64. In pratica, il valore si misura su risultati scientifici e industriali, non solo su ranking.
Quali settori beneficeranno di più di un supercomputer zettascale?
I benefici maggiori arrivano dove AI e simulazione richiedono enorme parallelismo: climate modeling, drug discovery, materiali avanzati e digital twin industriali. Anche la ricerca pubblica guadagna in velocità di sperimentazione, mentre le imprese possono ridurre tempi di R&D e test virtuali.