Tech News /
L'indipendenza del silicon sinocentrico: Alibaba presenta Zhenwu V900 e la nuova roadmap da 10 Trilioni di parametri
Alibaba svela il chip Zhenwu V900: 3 volte più potente del predecessore. Semiconduttori, data center da 20 GW e la risposta della Cina ai limiti USA.

Smart Shaped
All’Apsara Conference 2026 Alibaba ha presentato l’acceleratore AI Zhenwu V900 (T-Head) e una roadmap Qwen verso modelli da 5–10 trilioni di parametri. I numeri più citati (216 GB memoria, 1.200 GB/s inter-chip, cluster fino a 500.000 schede) sono dichiarazioni riportate dalla stampa: la competitività reale dipenderà da benchmark indipendenti, software stack e capacità data center (target 20 GW).
Che cosa ha annunciato Alibaba all'Apsara Conference 2026?
Alibaba (gruppo tecnologico cinese) ha annunciato due elementi centrali: il chip AI Zhenwu V900 di T-Head (divisione semiconduttori) e una roadmap dei modelli Qwen (famiglia di LLM) verso 5–10 trilioni di parametri. Eddie Wu (CEO di Alibaba Group) ha presentato il tutto come una strategia full-stack che integra semiconduttori, cloud compute, networking e modelli foundation, con disponibilità commerciale del V900 prevista per Q1 2027.
È importante distinguere: molte specifiche sono fatti riportati da testate che citano l’evento, mentre il posizionamento (“più potente in Cina”, “3x rispetto a M890”) resta un claim aziendale finché non emergono benchmark standardizzati. Reuters (22 settembre 2026) riporta anche la possibilità di cluster fino a 500.000 chip e il salto 3x vs M890, attribuendolo a Wu.
Wu said the processor delivers three times the performance of its predecessor, the M890, and can be linked in clusters of up to 500,000 chips to train and run the largest AI models.
— Eddie Wu, Chief Executive Officer, Alibaba Group
Fonti: Reuters (2026) e ABC News (2026).
- V900: 216 GB memoria, 1.200 GB/s inter-chip (Macau Business, 2026)
- Performance: “3x vs M890” (claim Alibaba via Reuters, 2026)
- Scala: fino a 500.000 acceleratori in cluster (Reuters, 2026)
- Go-to-market: mass production e release commerciale in Q1 2027 (ForkLog, 2026)
Quali specifiche rende rilevante Alibaba Zhenwu V900?
Zhenwu V900 (acceleratore per training e inference LLM) è rilevante perché prova a portare in Cina una piattaforma “di sistema”, non solo un singolo chip: compute, memoria e interconnect pensati per cluster enormi su Alibaba Cloud. Secondo la copertura di settore, il V900 integra 216 GB di memoria, con connettività inter-chip fino a 1.200 GB/s e supporto a FP8 e FP4 (formati di calcolo a bassa precisione utili per efficienza e throughput) (Macau Business, 2026).
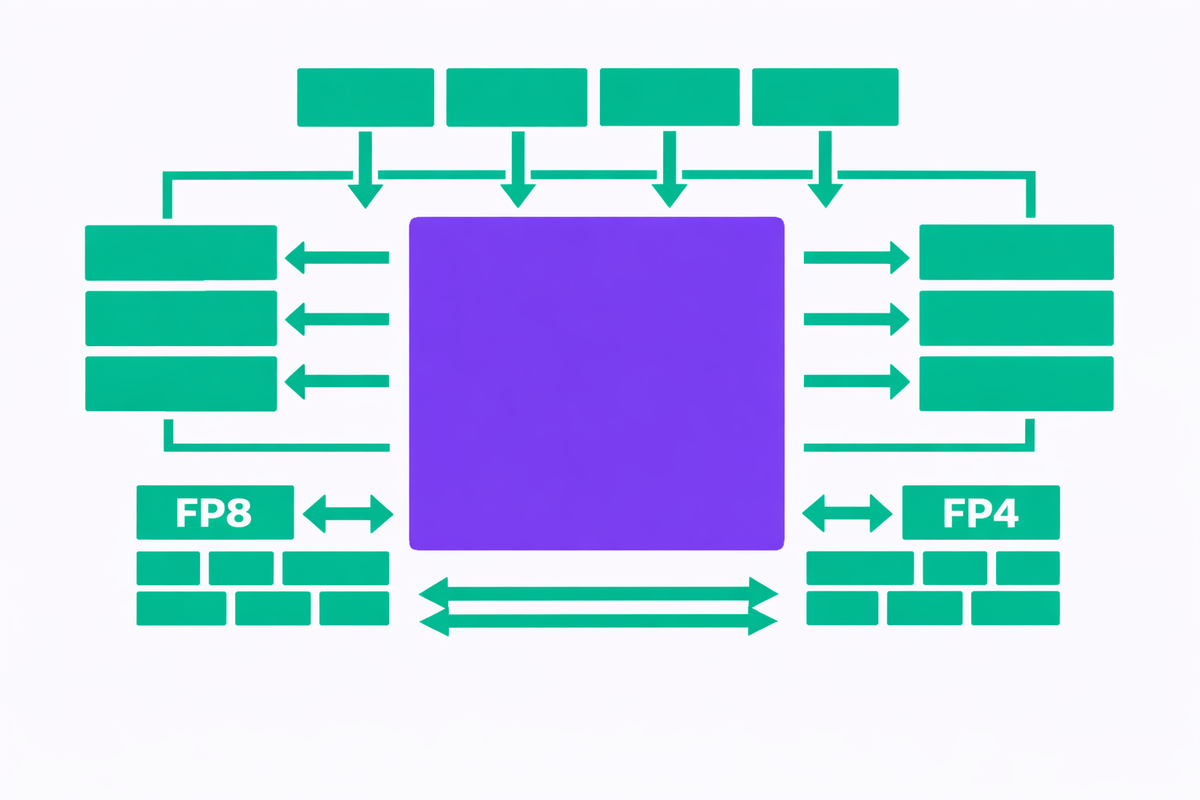
- Triplicazione delle prestazioni: Offre una potenza elaborativa pari a tre volte quella della generazione M890 (claim Alibaba riportato da Reuters, 2026).
- Scalabilità di Cluster senza precedenti: L'architettura è stata progettata per supportare super-cluster in grado di orchestrare fino a 500.000 schede interconnesse in parallelo (Reuters, 2026).
- Mass Production: La produzione di massa e la distribuzione commerciale a pieno regime sono pianificate per il Q1 2027 (ForkLog, 2026).
Memoria, precisione e interconnect contano perché determinano (1) batch size e sequenze più lunghe nel training, (2) costo/token in inference, (3) efficienza della parallelizzazione. Tuttavia, la metrica “3x vs M890” resta non verificata da benchmark indipendenti e non sostituisce misure come MLPerf o test comparabili tra stack software.
Come si confronta Zhenwu V900 con NVIDIA, Huawei e i chip Alibaba precedenti?
Un confronto utile deve separare dati divulgati da campi non pubblici e da “claim aziendali”. Per questo la tabella sotto usa solo valori riportati da fonti di stampa sull’Apsara Conference 2026 (Macau Business, Reuters, ForkLog) e marca come “non divulgato” ciò che non è presente nelle informazioni disponibili.
| Chip | Memoria | Inter-chip bandwidth | Precisione | Prestazioni vs predecessore | Cluster scale | Stato verifica |
|---|---|---|---|---|---|---|
| Alibaba Zhenwu V900 | 216 GB (report) | 1.200 GB/s (report) | FP8/FP4 (report) | “3x vs M890” (claim) | Fino a 500.000 (claim/report) | Parziale (stampa, no benchmark) |
| Alibaba Zhenwu M890 | Non divulgato | Non divulgato | Non divulgato | — | Non divulgato | Limitato (dati pubblici scarsi) |
| NVIDIA H100 / Blackwell (B200) | Non in questo set fonti | Non in questo set fonti | Non in questo set fonti | — | Dipende da NVLink / fabric | Non comparabile qui (mancano dati citabili) |
| Huawei Ascend 910B/910C | Non in questo set fonti | Non in questo set fonti | Non in questo set fonti | — | Dipende da fabric | Non comparabile qui (mancano dati citabili) |
Dove il V900 sembra competitivo: l’enfasi su memoria (216 GB), interconnect (1.200 GB/s) e cluster scale (fino a 500.000) suggerisce un obiettivo chiaro: addestrare e servire frontier model su Alibaba Cloud riducendo i colli di bottiglia di rete e disponibilità di compute citati da team cinesi (es. DeepSeek come riferimento ricorrente nel dibattito).
Dove mancano dati: processo produttivo, power envelope, packaging/HBM, e soprattutto software stack (equivalente di CUDA per NVIDIA o CANN per Huawei). Senza questi elementi, ogni “vs NVIDIA/Huawei” resta ipotesi. Per un parallelo su NVIDIA e supply di training, vedi NVIDIA e l'innovazione nei dati sintetici per l'addestramento AI e, lato Huawei, Huawei e i modelli AI avanzati come Zhiji.
Che cosa significa davvero la roadmap Qwen verso 5-10 trilioni di parametri?
“5–10 trilioni di parametri” non significa automaticamente “5–10 volte più capacità”: conta se il numero descrive parametri totali, attivi (inference) o un’architettura Mixture-of-Experts (MoE, modello che attiva solo una parte degli “esperti” per token). Reuters (2026) riporta che Qwen 4 è in addestramento e che le versioni successive Qwen 4.5 e Qwen 5 sono attese nella fascia 5–10T.
Alibaba cita anche tecniche di Recursive Self-Improvement (RSI) (auto-miglioramento ricorsivo: il sistema conduce esperimenti, genera dati sintetici e corregge errori). Un esempio concreto: un coding agent addestra micro-varianti del proprio valutatore su bug reali, sintetizza test e seleziona la policy che riduce regressioni, iterando per cicli.
| Modello Qwen | Stato (report) | Obiettivo di scala | Date pubbliche |
|---|---|---|---|
| Qwen3.8-Max | Rilasciato (report) | 2,4T parametri (citato nel contesto) | Non specificate qui |
| Qwen 4 | In training (Reuters, 2026) | Non divulgato | Non divulgate |
| Qwen 4.5 | Roadmap (Reuters, 2026) | Verso 5–10T (atteso) | Non divulgate |
| Qwen 5 | Roadmap (Reuters, 2026) | 5–10T (target) | Non divulgate |
La credibilità della roadmap dipende da cluster (V900), memoria, rete e data center: più parametri e contesto richiedono più GPU memory, più banda east-west e più stabilità operativa su larga scala. Un confronto con altre roadmap LLM: Evoluzione degli LLM e roadmap AI di Amazon.
Perché 20 gigawatt di data center sono decisivi per la strategia AI di Alibaba?
I 20 GW di data center sono decisivi perché l’AI su scala “trillion” è prima di tutto un problema industriale: energia, raffreddamento, rete e capex. “20 GW” è una metrica di capacità elettrica installata (quanto carico possono sostenere i siti), non solo metri quadri. Se l’obiettivo è far girare cluster da centinaia di migliaia di acceleratori (V900), la disponibilità di potenza e l’efficienza (PUE) diventano vincoli duri.
In pratica, l’economia passa da: densità per rack, liquid cooling (raffreddamento a liquido), NIC e fabric di rete, e costi operativi (OPEX) legati a energia e manutenzione. Sul fronte ambientale contano PUE (Power Usage Effectiveness), mix rinnovabili, vincoli idrici e carbon footprint. Per il contesto infrastrutturale globale vedi L'infrastruttura supercomputing e la strategia AI globale e, lato sostenibilità, Strumenti per l'implementazione ESG e sostenibilità aziendale.
| Metrica | Perché conta | Implicazione per Qwen 5–10T |
|---|---|---|
| Capacità elettrica (GW) | Limite massimo del compute installabile | Determina scala cluster e uptime |
| PUE | Quota energia “non-IT” (cooling, UPS) | Riduce costo/token e emissioni |
| Rack density | kW per rack e layout di sala | Abilita più acceleratori per sito |
| Liquid cooling | Gestisce alte densità e heat flux | Stabilizza training prolungati |
| Network fabric | Banda east-west per parallelismo | Evita colli di bottiglia su MoE/RSI |
Quali casi d'uso enterprise può abilitare la strategia full-stack di Alibaba?
La combinazione tra chip proprietari Zhenwu, modelli Qwen e Alibaba Cloud punta a ridurre costo inferenziale, dipendenza estera e time-to-deployment per clienti enterprise. Per un buyer B2B, la metrica non è “quanti parametri”, ma prezzo per token, latenza, throughput, affidabilità e integrazione con governance e compliance.
- Knowledge assistant bancario: Q&A su policy, credito e procedure interne con audit trail.
- Copilota per sviluppo software: refactoring, test generation e triage su repository aziendali.
- Customer service multilingua: routing e risposta su canali digitali con SLA misurabili.
- Automazione documentale: estrazione dati da contratti e delibere, con controlli di qualità.
- Ricerca accademica: analytics su corpora e dataset scientifici, con policy di accesso.
La strategia full-stack di Alibaba trova applicazione in diversi casi d'uso enterprise, con particolare attenzione a settori regolamentati e gestione dei dati. L’adozione di soluzioni AI richiede attenzione a MLOps, Data Governance e conformità normativa: Governance AI e compliance con il regolamento EU AI Act. Anche le organizzazioni di piccole e medie dimensioni possono beneficiare di queste tecnologie: Adozione AI nelle PMI e casi d'uso enterprise.
Quanto è realistica l'indipendenza del silicon cino-centrico di Alibaba?
L’“indipendenza” del silicon cino-centrico è reale sul piano del design e dell’integrazione full-stack (T-Head + Alibaba Cloud + Qwen), ma non coincide con autosufficienza totale della supply chain. Restano anelli critici: nodi produttivi (foundry come SMIC o TSMC), packaging avanzato, HBM (High Bandwidth Memory), equipment litografico e tool EDA (Electronic Design Automation) spesso legati a ecosistemi globali.
Le restrizioni export USA su semiconduttori avanzati e infrastrutture spingono attori come Alibaba, Huawei e Baidu verso stack domestici e architetture hardware-agnostic, riducendo la dipendenza da forniture come NVIDIA. Reuters (2026) inquadra esplicitamente V900 e Qwen come risposta strategica a questo contesto.
Wu said Alibaba’s Qwen team plans to train a new model with 5 trillion to 10 trillion parameters, to tackle more complex, longer-horizon tasks as it pursues an artificial superintelligence.
— Eddie Wu, Chief Executive Officer, Alibaba Group
Per un’analisi geopolitica più ampia (USA-Cina-Europa): Geopolitica AI: USA, Cina e le sfide globali. Fonti aggiuntive sulla notizia: Macau Business (2026) e New Straits Times (22 settembre 2026).
FAQ: domande frequenti su Alibaba Zhenwu V900, Qwen e la roadmap AI
Quando arriverà Alibaba Zhenwu V900 sul mercato?
La mass production e la release commerciale del chip Zhenwu V900 sono indicate per il primo trimestre 2027 (Q1 2027) nelle informazioni riportate dalla stampa. La disponibilità effettiva per clienti Alibaba Cloud e partner dipenderà anche da volumi, supply chain e integrazione software.
Esistono già benchmark indipendenti su Zhenwu V900?
Al momento, i dati più citati (come “3x rispetto a M890”) risultano attribuiti ad Alibaba e ripresi dai media. Senza benchmark pubblici e comparabili (stesso workload, stessa configurazione, stesse metriche), non è possibile stimare con precisione il gap rispetto a NVIDIA o Huawei.
Che differenza c’è tra 10 trilioni di parametri e capacità reale del modello?
Il numero di parametri misura la dimensione del modello, ma non garantisce prestazioni lineari. Conta se i parametri sono totali o attivi (es. Mixture-of-Experts), la qualità dei dati, l’ottimizzazione dell’inference e il contesto massimo gestibile. In produzione, latenza e costo/token pesano quanto l’accuratezza.
Quali aziende potrebbero usare Qwen in produzione?
Qwen è rilevante per aziende che vogliono integrare assistenti su knowledge base interne, automazione documentale e customer operations, soprattutto se già presenti nell’ecosistema Alibaba Cloud. In settori regolati (banking, università, PA) la scelta dipende da governance, auditabilità, privacy e controlli di rischio.
Qual è il principale rischio per la roadmap V900 + Qwen 5–10T?
Il rischio principale è l’allineamento tra tre piani: disponibilità reale di acceleratori (volumi e affidabilità), maturità dello stack software per training/inference e capacità data center (energia, raffreddamento, rete). Se uno dei tre fattori rallenta, anche una roadmap ambiziosa sui parametri può perdere trazione.