AI /
Falcon Mamba: Una nuova frontiera nell'elaborazione del linguaggio naturale
Falcon Mamba 7B: l'LLM open-weight senza Transformer. Scopri come l'architettura Mamba gestisce contesti lunghi riducendo i costi di memoria e latenza.

Smart Shaped
Ultimo aggiornamento: agosto 2026
Falcon Mamba 7B è un language model open-weight da 7 miliardi di parametri del Technology Innovation Institute (TII), basato sull’architettura Mamba (un State Space Language Model, SSLM). È progettato per gestire contesti lunghi con un profilo di memoria più efficiente rispetto ai Transformer in alcuni workload. Nei report tecnici è indicato un training su ~5,8T token e una natura “pure state-space” senza self-attention.
Che cos'è Falcon Mamba 7B e perché conta per il NLP nel 2026
Falcon Mamba 7B (LLM open-weight) è un modello linguistico da 7 miliardi di parametri sviluppato dal Technology Innovation Institute di Abu Dhabi e distribuito nell’ecosistema Hugging Face. La sua particolarità è l’uso di Mamba (architettura state-space) al posto della self-attention tipica dei Transformer, con l’obiettivo di scalare meglio su contesti lunghi. Secondo una scheda tecnica strutturata sulla famiglia Falcon, il modello è addestrato su circa 5,8 trilioni di token e usa una finestra di training intorno agli 8K token (Systems Analysis, aggiornato 2026: https://systems-analysis.ru/eng/Falcon_(language_model_family)).
State Space Language Model (SSLM) (modello linguistico a spazio di stato) significa che il modello aggiorna uno “stato” interno lungo la sequenza invece di confrontare ogni token con tutti gli altri. Nel 2026 il tema conta perché molte pipeline NLP reali (RAG, compliance, ricerca) richiedono long-context e costi prevedibili.
- Più contesto utile su documenti lunghi (report, policy, paper).
- Efficienza migliore in memoria/throughput in alcune inferenze long-sequence.
- Sperimentazione facilitata dall’accesso open-weight su Hugging Face.
Come funziona Falcon Mamba
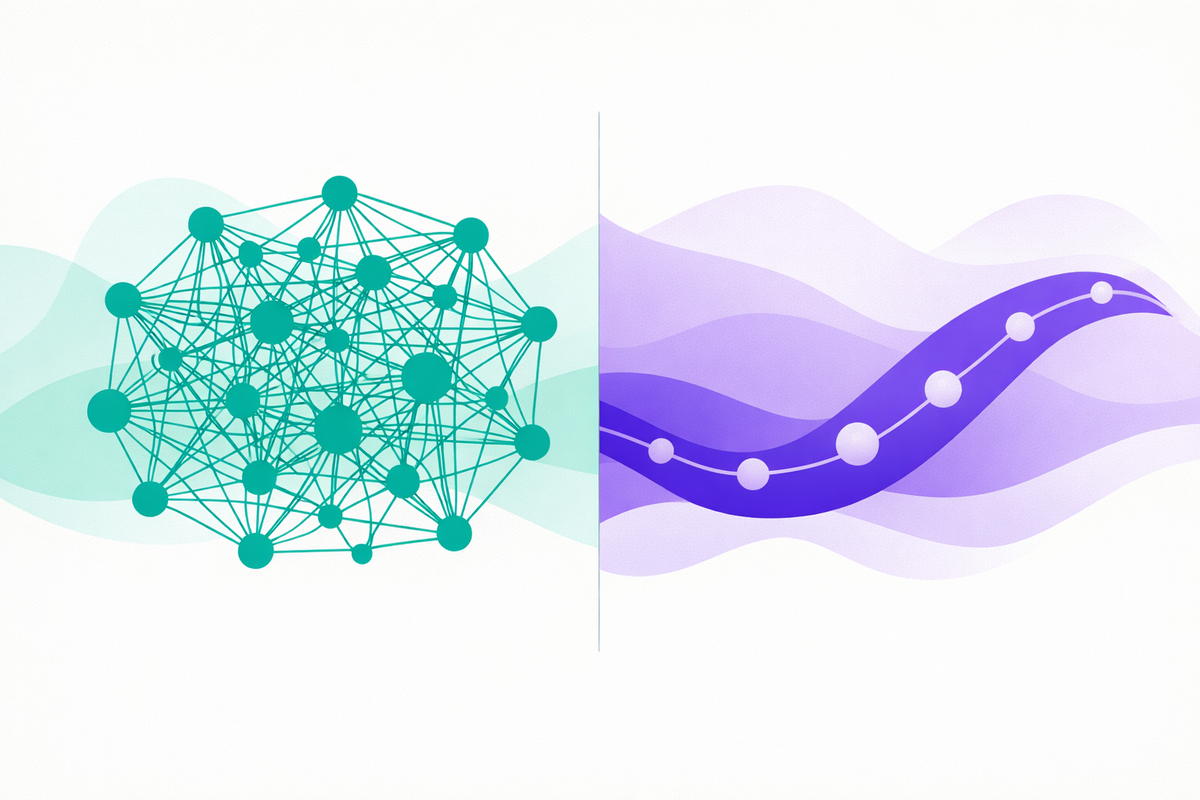
Falcon Mamba elabora testo lungo senza basarsi sulla self-attention completa dei Transformer. Invece di confrontare ogni parola con tutte le altre (modelli tradizionali Transformer), l’architettura Mamba aggiorna continuamente lo “stato” mentre elabora le parole, concentrandosi sulle informazioni più rilevanti. Questo approccio differente, permette di gestire sequenze testuali più lunghe senza compromettere le prestazioni.
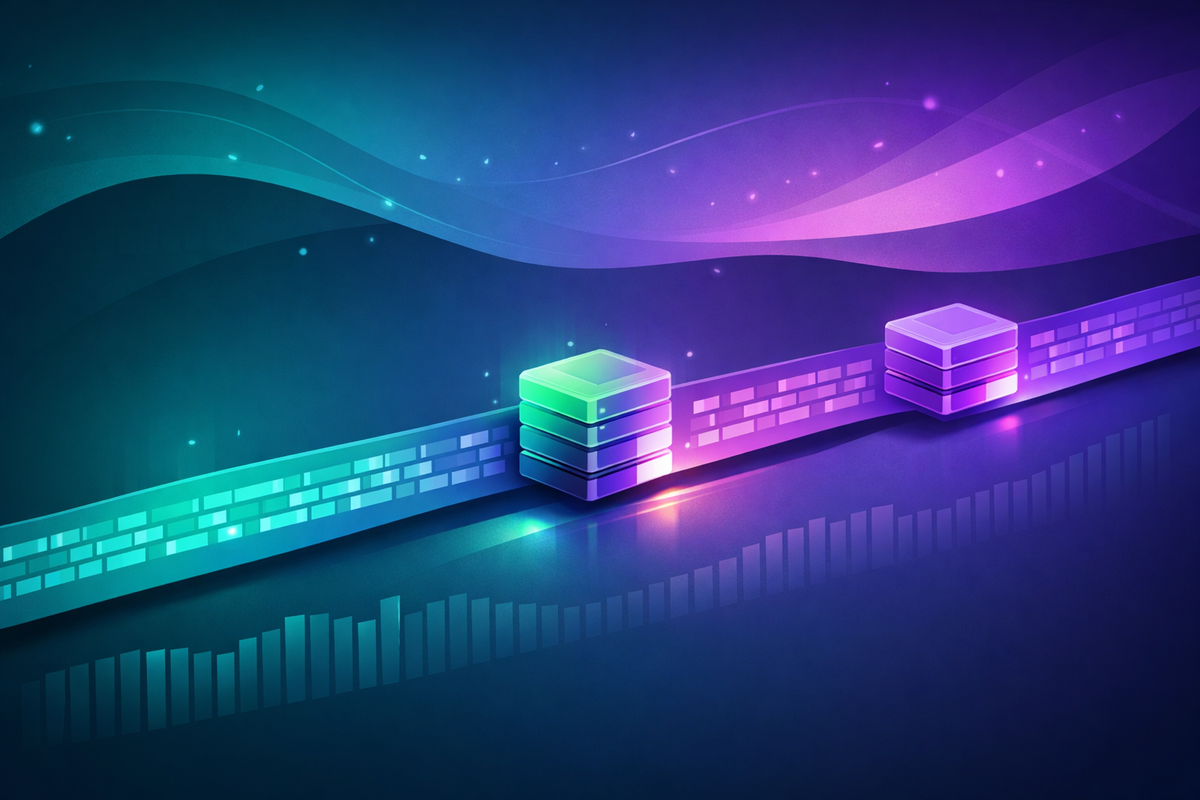
Come suggerisce la Figura 1, lo stato interno viene aggiornato passo dopo passo: l’aumentare della lunghezza delle sequenze non comporta né un aumento significativo dell’utilizzo della memoria, grazie all’architettura più efficiente, né una diminuzione della velocità di generazione dei testi.
In pratica, un state space model (modello a spazio di stato) tende ad avere una complessità più favorevole su sequenze lunghe rispetto alla self-attention quadratica. Questo è coerente con le descrizioni comparative che attribuiscono ai modelli Mamba complessità temporale lineare e memoria sostanzialmente costante in funzione del contesto (Vantaige, 2026: https://vantaige.io/ai-tool/falcon).
Falcon Mamba, inoltre, è stato addestrato su un vasto dataset di dati web raffinati e dati tecnici “di alta qualità” per garantire prestazioni elevate (Kunsch, 2026: https://www.alphaxiv.org/@guillaume-kunsch).
Perché Falcon Mamba è innovativo: i benchmark che lo rendono competitivo
Falcon Mamba 7B è innovativo perché è tra i primi modelli “pure Mamba” a scala 7B realmente competitivi con modelli Transformer open-weight in benchmark generalisti, pur con un’impostazione architetturale diversa. Nel report tecnico 2026 viene presentato come base model Mamba addestrato su 5,8T token con data mix curato (Kunsch, 2026: https://www.alphaxiv.org/@guillaume-kunsch).
In this technical report, we present Falcon Mamba 7B, a new base large language model based on the novel Mamba architecture, trained on 5.8 trillion tokens with carefully selected data mixtures.
— Guillaume Kunsch, Lead author of the Falcon Mamba 7B technical report
| Modello | Architettura | Scala training (fonte/anno) | Punto di forza | Nota benchmark |
|---|---|---|---|---|
| Falcon Mamba 7B | Pure Mamba (SSLM) | ~5,8T token (Kunsch, 2026) | Efficienza long-context | Competitivo su leaderboard open |
| Mistral 7B | Transformer | N/D qui (non confrontabile 1:1) | Tooling maturo | Baseline frequente nei test |
| Llama 3.1 8B | Transformer | N/D qui (non confrontabile 1:1) | Generalità e comunità | Spesso forte su task generali |
| Falcon2 11B | Transformer | N/D qui (famiglia Falcon) | Robustezza generale | Vicino per score medio |
| Altri SSLM (2026) | SSM / ibridi | Classificazione (Local AI Master, 2026) | Efficienza mirata | Non tutti “pure” |
“Competitivo” non significa “migliore in ogni task”: i benchmark variano per dataset, prompt e harness. Un riferimento spesso citato in comparazioni è la Open LLM Leaderboard su Hugging Face, dove Falcon Mamba è stato discusso come SSLM open tra i più forti al lancio (Vantaige, 2026: https://vantaige.io/ai-tool/falcon). La lettura corretta è: prestazioni solide + vantaggio architetturale potenziale su contesti lunghi, da validare sul proprio dominio.
Falcon Mamba vs Transformer e altri SSLM: differenze pratiche di architettura ed efficienza
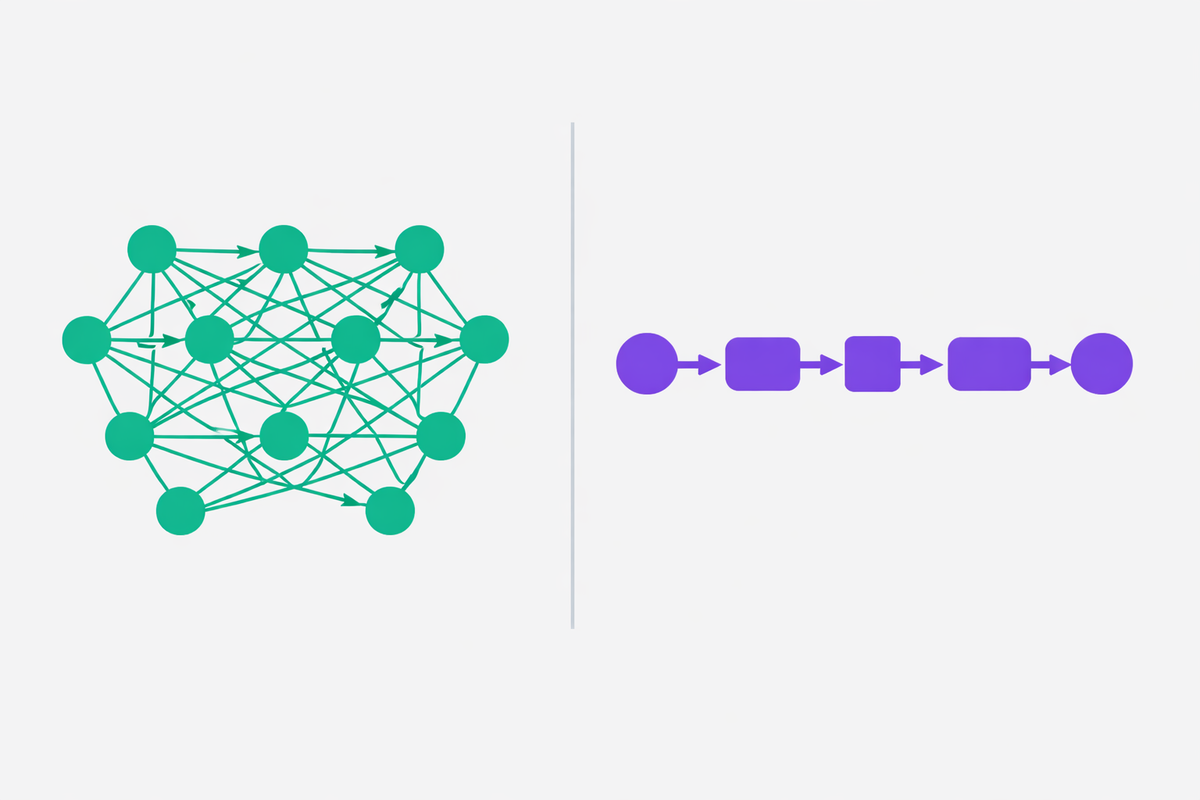
Falcon Mamba non sostituisce tutti i Transformer, ma offre un vantaggio specifico nella gestione efficiente di contesti lunghi e nel profilo memoria/throughput di alcuni workload. In un SSLM come Mamba, l’elaborazione è basata su state update (aggiornamento di stato) invece che su self-attention completa, e questo cambia soprattutto l’inferenza su sequenze lunghe (Vantaige, 2026: https://vantaige.io/ai-tool/falcon; Local AI Master, 2026: https://localaimaster.com/blog/mamba-state-space-models-guide).
| Criterio | Falcon Mamba (SSLM) | Transformer classico | Quando conviene |
|---|---|---|---|
| Meccanismo core | State update (Mamba) | Self-attention | SSLM per contesti lunghi |
| Memoria su long-context | Più stabile | Cresce con la sequenza | Doc lunghi, QA su report |
| Parallelizzazione training | Diversa/meno standard | Molto ottimizzata | Transformer per training mainstream |
| Tooling & integrazioni | In crescita | Molto maturo | Transformer per ecosistemi complessi |
| Fine-tuning | Possibile (es. LoRA) | Molto documentato | Transformer se team junior |
Operativamente, molti team usano PyTorch (framework) e Hugging Face Transformers (libreria) come standard per deployment. Per questo, anche se un modello Mamba può essere efficiente, il rischio di frizione (tooling, quantizzazione, monitoraggio) va pesato: un Transformer come Mistral o Llama resta spesso la scelta “più sicura” quando servono integrazioni rapide e molte feature pronte. Per una lettura più ampia sulle architetture oltre Transformer nel 2026, vedi l’overview tecnica (Youngju.dev, 2026: https://www.youngju.dev/blog/culture/2026-05-16-foundation-model-architectures-beyond-transformer-2026-mamba-hyena-rwkv-retnet-griffin-jamba-xlstm-ttt-dit-moe-flash-attention-3-deep-dive.en).
Dati di training, licenza e stato dell'ecosistema Falcon Mamba
Falcon Mamba deriva la propria competitività anche da una scala di addestramento ampia e da una disponibilità open che ne facilita la sperimentazione. Un profilo tecnico riporta ~5,8T token di training e colloca Falcon Mamba 7B come modello “pure” basato su Mamba (Systems Analysis, aggiornato 2026: https://systems-analysis.ru/eng/Falcon_(language_model_family)). Nel report 2026 vengono anche menzionati molteplici checkpoint/varianti, inclusi checkpoint quantizzati disponibili su Hugging Face (Kunsch, 2026: https://www.alphaxiv.org/@guillaume-kunsch).
Sul dataset, le descrizioni pubbliche parlano di web raffinato (corpora puliti), dati tecnici (documentazione e testo specialistico) e mix selezionati per qualità (Kunsch, 2026). Per la licenza: verificare sempre la model card su Hugging Face e la voce “license” del rilascio, perché “open-weight” non equivale automaticamente a “uso libero senza vincoli”. Se serve un ripasso operativo, vedi le differenze tra open source e software gratuito.
Segnali di ecosistema: oltre a repository e model card, la trazione si misura spesso in discussioni e issue. Per contenuti freschi, la guida 2026 sugli SSLM include Falcon Mamba in una tabella che distingue i “pure Mamba” dai successivi ibridi (Local AI Master, 2026: https://localaimaster.com/blog/mamba-state-space-models-guide).
Dove Falcon Mamba crea valore: use case, RAG e scenari ad alto contesto
Falcon Mamba 7B è particolarmente interessante quando il problema richiede gestione di testi lunghi, costi sotto controllo e pipeline NLP ripetibili. In scenari RAG (Retrieval-Augmented Generation, generazione con recupero da fonti) la disponibilità di contesto efficiente può ridurre la pressione su chunking aggressivo e su catene di riassunti, soprattutto in question answering (QA) su documenti lunghi. In pratica, l’obiettivo è avere risposte più coerenti senza aumentare troppo memoria e latenza.
Use case tipici: (1) summarization di report e verbali lunghi, (2) QA su policy e manuali tecnici, (3) analisi documentale e classificazione su grandi archivi, (4) generazione assistita di testo per knowledge base interne. Per una vista operativa su numeri e scelte di messa in produzione, è utile l’analisi completa del deployment LLMOps nel 2025.
Limiti, rischi e quando Falcon Mamba non è la scelta migliore
Falcon Mamba è promettente, ma non elimina i compromessi tipici dei modelli open-weight e delle architetture emergenti. Il primo limite è la maturità dell’ecosistema: il mondo Transformer (Llama, Mistral) ha tooling, best practice e integrazioni più consolidate per quantizzazione, serving e osservabilità. Questo conta in ambienti enterprise dove la prevedibilità operativa pesa quanto l’accuratezza.
Secondo limite: i benchmark non sono sempre confrontabili uno-a-uno. Leaderboard diverse usano set, prompt e metriche differenti; un vantaggio su long-context non garantisce superiorità su ragionamento, coding o tool-use. Terzo limite: safety/alignment (riduzione di hallucination, bias, controlli) spesso richiede valutazioni dedicate, soprattutto per domini sensibili.
Per la banking compliance (conformità), è necessario un processo di validazione che includa test su dati rappresentativi, auditabilità, logging e policy sugli output. Bisogna monitorare i rischi di qualità dei dati e la degradazione delle prestazioni nel tempo, considerando anche i rischi di model collapse nell'intelligenza artificiale. Un Transformer è spesso la scelta più sicura per ridurre i rischi e rispettare i requisiti normativi.
Vale la pena provare Falcon Mamba? Valutazione finale e FAQ
Verdict. Falcon Mamba 7B vale la prova se il tuo caso d’uso è long-context (documenti lunghi, RAG, analisi testuale su archivi) e puoi investire in una fase di valutazione tecnica su stack Hugging Face/PyTorch. È meno indicato se servono integrazioni “plug-and-play”, massima maturità del tooling o garanzie di safety già ampiamente standardizzate. Per aziende banking e università, l’approccio migliore è un pilot controllato con metriche, governance e test su dati reali.
Quanto costa usare Falcon Mamba 7B in produzione?
Falcon Mamba 7B non ha un “costo di licenza” unico: il costo principale è infrastruttura (GPU/CPU), serving e governance. Un vantaggio dichiarato degli SSLM è un profilo di memoria più stabile su contesti lunghi, che può ridurre sprechi in alcuni workload (Vantaige, 2026).
Qual è la differenza più importante tra Falcon Mamba e un Transformer come Llama o Mistral?
La differenza principale è architetturale: Falcon Mamba usa un meccanismo di state update (SSLM) invece della self-attention tipica dei Transformer. Questo può favorire l’efficienza su sequenze lunghe, mentre i Transformer restano spesso superiori per maturità di tooling, ottimizzazioni e integrazioni standard.
La licenza permette l’uso commerciale di Falcon Mamba 7B?
La risposta dipende dalla licenza indicata nella model card e nel rilascio ufficiale. “Open-weight” non equivale automaticamente a “uso commerciale senza vincoli”. Prima di rilasciare un prodotto, verifica le clausole, i requisiti di attribuzione e le eventuali limitazioni d’uso previste dalla licenza del modello.
Quanto tempo serve per integrare Falcon Mamba 7B in una pipeline RAG?
Un’integrazione base (caricamento modello, inference endpoint, retrieval da vector database e prompt template) richiede spesso 1–3 giorni di lavoro per un team esperto, più il tempo di valutazione su dataset reali. In domini regolati (banking) va aggiunta la fase di governance, logging e validazione.
Falcon Mamba 7B è adatto a lingue diverse dall’inglese e a task lunghi?
È adatto soprattutto a task lunghi quando il contesto è il collo di bottiglia, ma la qualità per singola lingua dipende dal data mix di training e dalla valutazione sul tuo dominio. Come riferimento tecnico, il training è riportato a ~5,8T token (Systems Analysis, aggiornato 2026), ma serve sempre un test mirato su italiano e linguaggi specialistici.